Hallo,
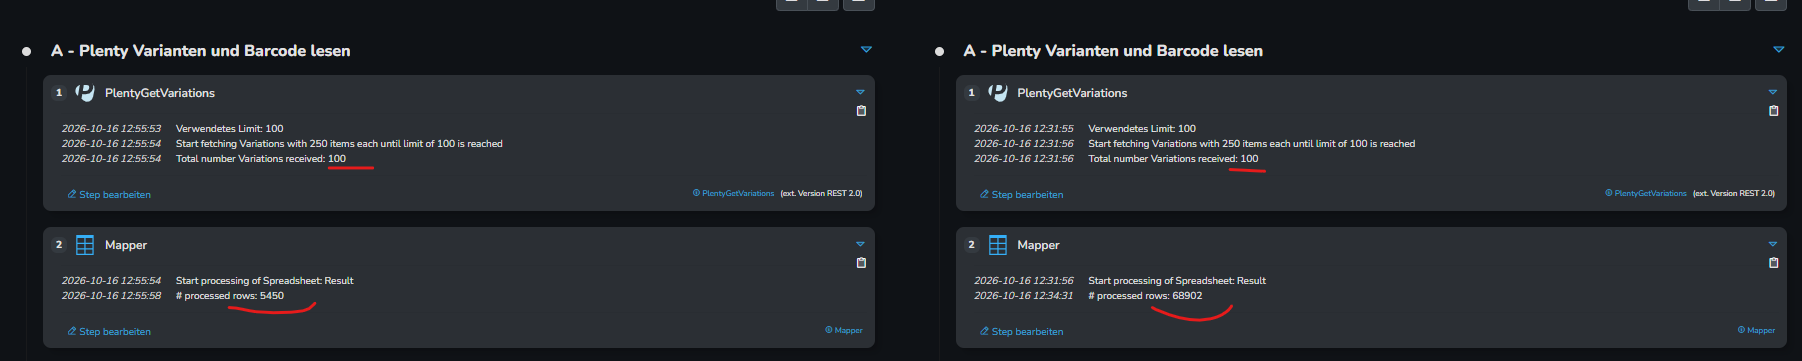
ich habe in meinem Flow eine eigenartige Ausgabe. Bei gleichem Abruf aus Plenty liefert der Mapper zum einen einen sehr hohen Wert der verarbeiteten Zeilen und zum anderen auch unterschiedlich.
Könnt ihr euch das erklären?
Gruß und Danke
Stefan
Hallo Stefan,
das hängt davon ab, wieviele andere Schritte diese Daten verwenden. Das Ergebnis des Spreadsheet wird nicht im Cache gehalten, sondern für jeden konsumierenden Schritt erneut durchlaufen und zählt bei jedem Durchlauf auch die „processed rows“-Variable weiter hoch.
Im rechten Fall hast du wohl deutlich mehr Schritte, welche irgendwas mit den Daten machen. Das kann man auch gut an den Zeiten neben dem Schritt sehen. Im rechten Fall wurde der Mapper fast 3 Minuten lang verwendet während es links nur 4 Sekunden sind.
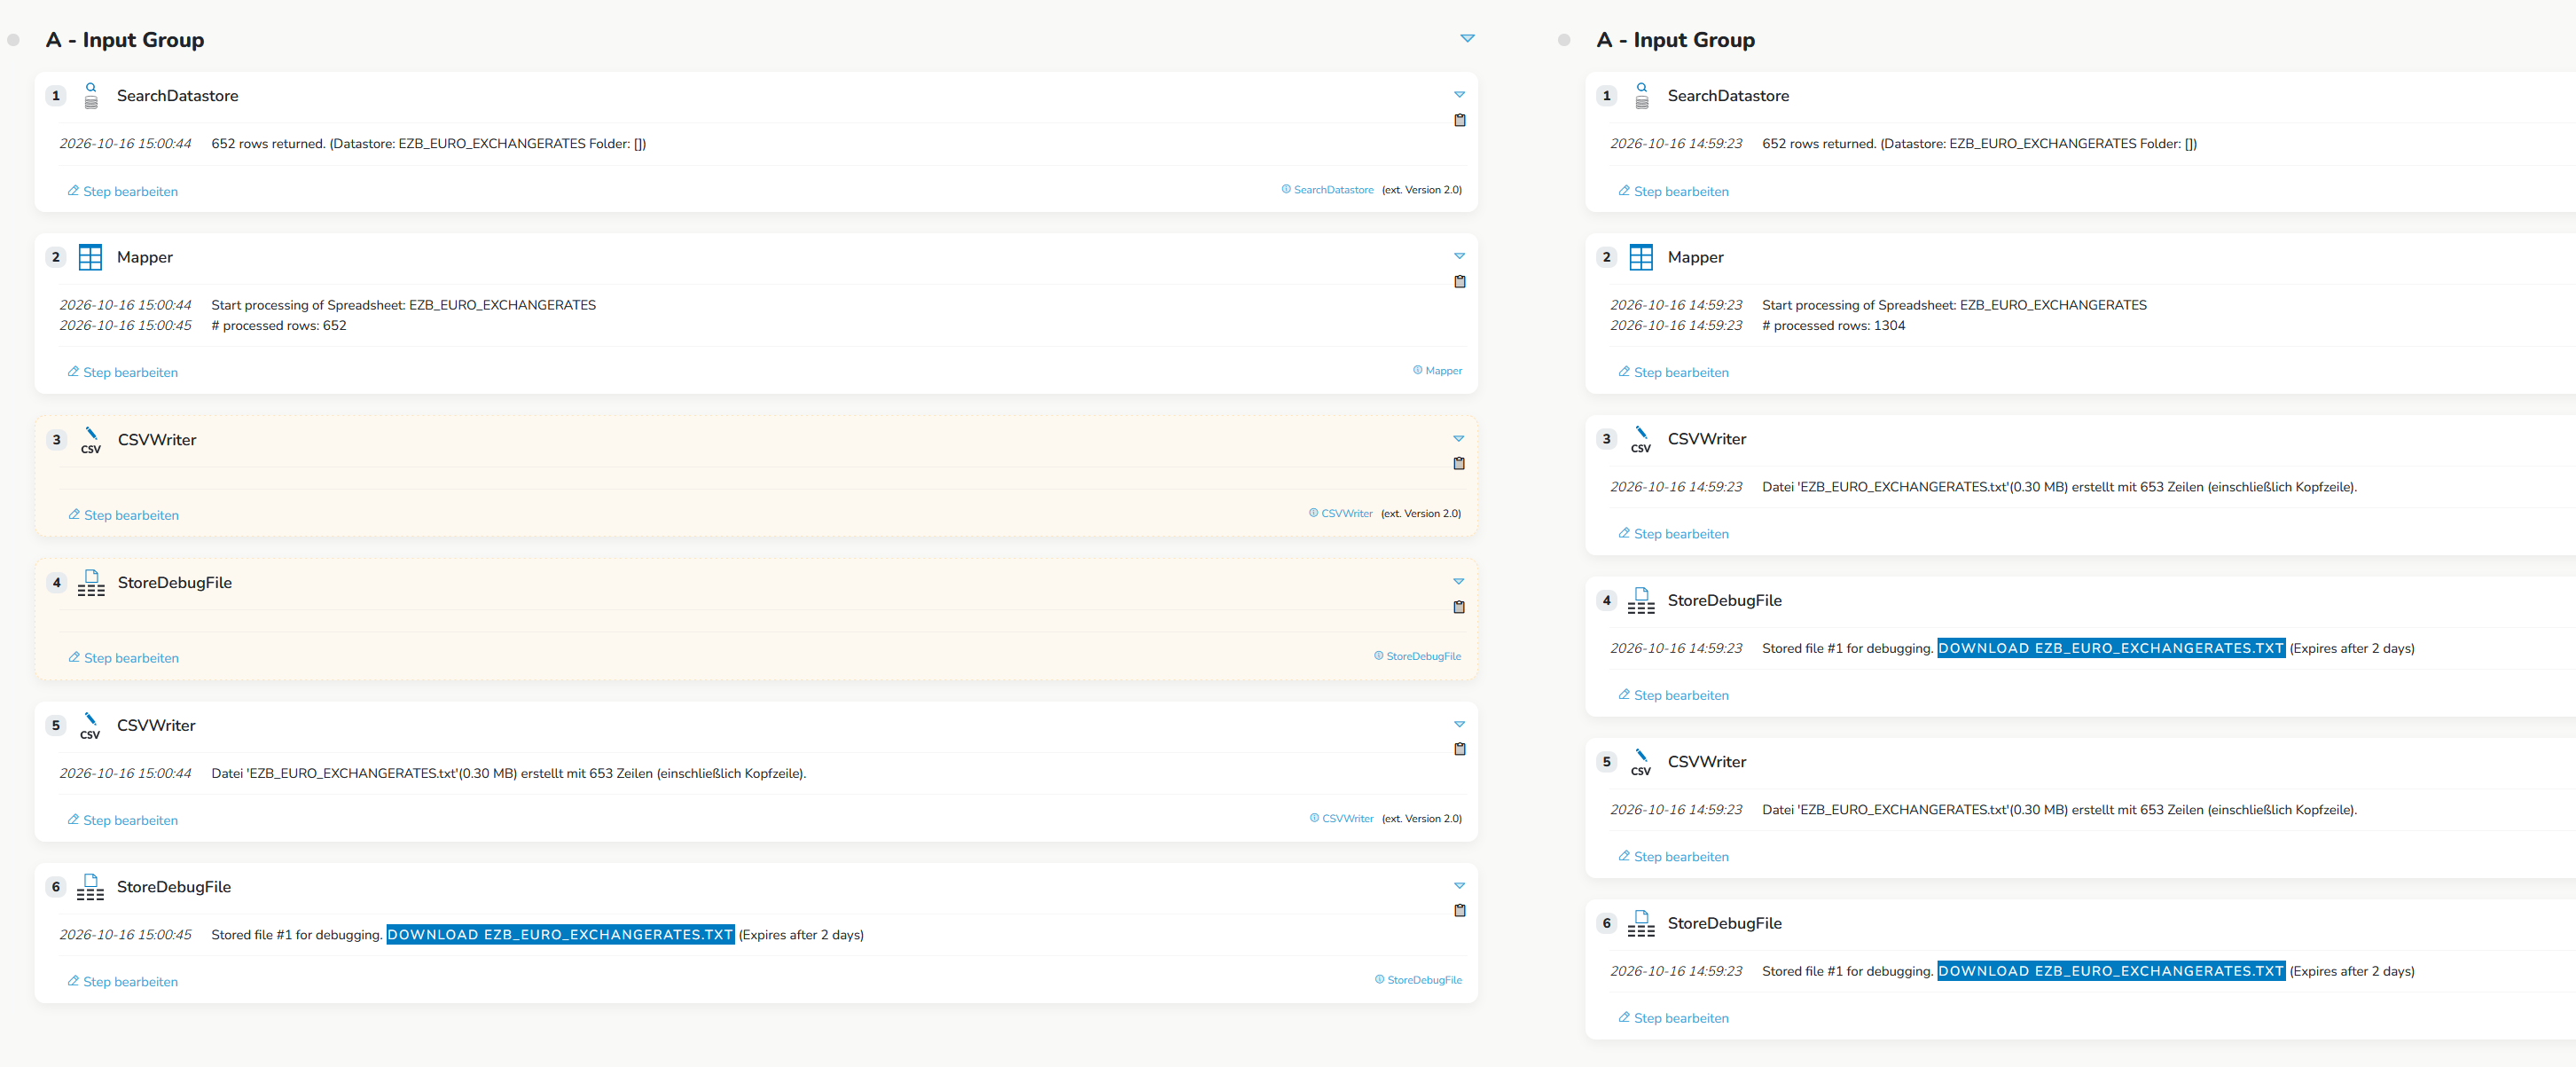
Hier ein ganz einfaches Beispiel:
Mit 2x CSV Writer ist Processed Rows doppelt so groß wie meine tatsächlich vorhandenen Datenzeilen.
Gruß
Gustav
1 „Gefällt mir“